基于vLLM的Qwen3.8-27B大模型高性能推理服务构建与OpenAI兼容网关部署实践
| 项目 | 内容 |
|---|---|
| 文档版本 | v1.0 |
| 文档日期 | 2026-08-22 |
| 文档作者 | Richard < richard@ponfey.com > |
| 适用系统 | Rocky Linux 10.2(内核 6.12.x) |
| 适用软件 | vLLM ≥ 0.29(v1)、Python 3.10–3.12、FastAPI、uvicorn |
| 适用模型 | Qwen/Qwen3.8-27B(HF/ModelScope) |
目录
1. 文档说明
1.1 目的
- 在 Rocky Linux 10 上配置 GPU 环境并安装 vLLM;
- 下载并加载 Qwen3.8-27B 多模态稠密模型;
- 以OpenAI 兼容接口(
/v1/chat/completions等)对外提供推理服务; - 使用 FastAPI 网关 对客户端请求做 SK(Secret Key)密钥鉴权、限流与转发;
- 完成systemd 托管、监控、安全加固与常见问题排查。
1.2 术语表
| 术语 | 说明 |
|---|---|
| vLLM | 高性能大模型推理引擎,提供 PagedAttention、Continuous Batching、KV Cache 管理等能力,内置 OpenAI 兼容 API 服务 |
| SK | Secret Key,客户端访问网关所需持有的密钥,用于鉴权 |
| OpenAI 兼容接口 | 与 OpenAI API 协议一致的 HTTP 接口(/v1/chat/completions、/v1/completions、/v1/models 等) |
| KV Cache | 推理过程中缓存的注意力键值对,显存占用大头 |
| MTP | Multi-Token Prediction,多 token 预测,Qwen3.8-27B 支持的可选加速模块 |
| TP | Tensor Parallelism,张量并行,将模型权重切分到多张 GPU 上 |
| SSE | Server-Sent Events,vLLM 流式输出的传输方式 |
| Reasoning | 推理思考模式,Qwen3.8-27B 默认开启,可输出 reasoning_content |
1.3 约定
- 文中模型本地路径统一使用
/data/vllm/models/Qwen3.8-27B; - 服务名统一为
qwen3.8-27b(对应--served-model-name); - SK 示例值为
sk-richard-11223355,生产环境务必替换为强随机密钥。
2. 总体架构
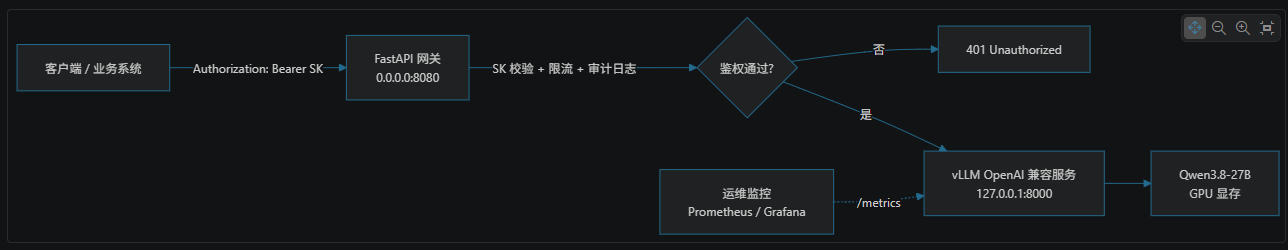
整个系统分为三层:客户端 → FastAPI 网关 → vLLM 推理服务。

请求鉴权时序:
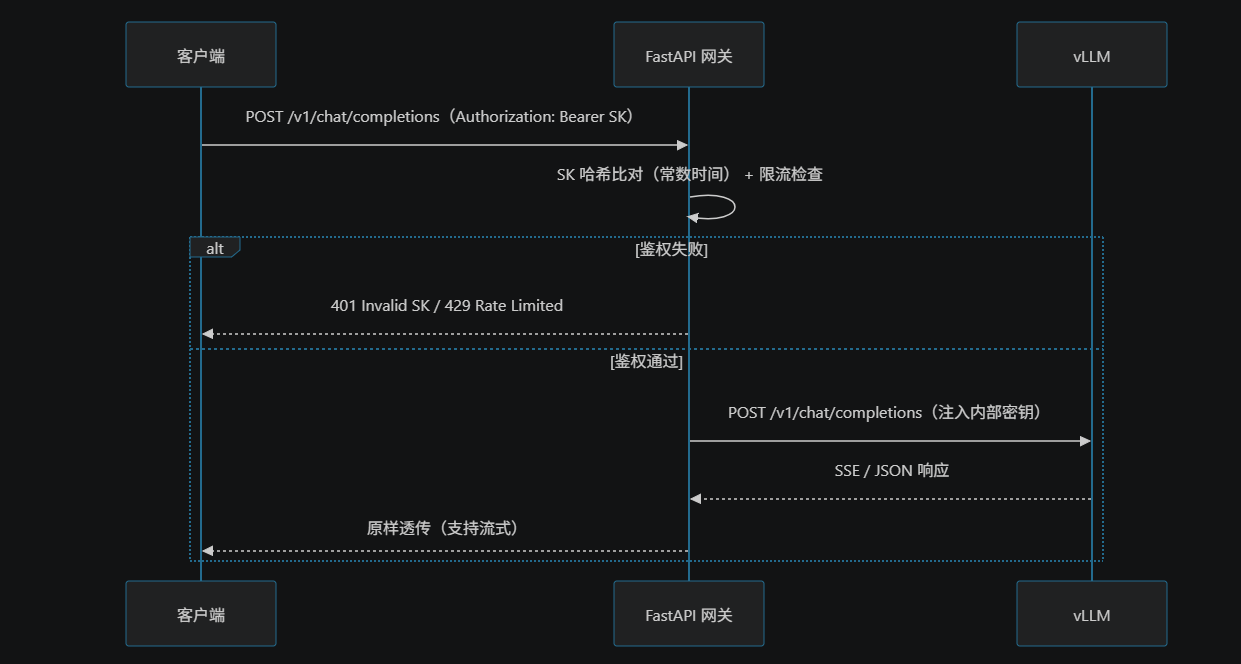
安全设计要点:
- vLLM 只监听
127.0.0.1:8000,不直接对外暴露; - 网关是唯一对外入口,负责 SK 鉴权、限流、审计;
- vLLM 自身再叠加一层
--api-key内部密钥(纵深防御),即使网关被穿透,vLLM 也不会裸奔; - 网关与 vLLM 之间走内网回环,密钥通过环境变量注入,不落盘到代码。
3. 环境准备
3.1 硬件与显存规划
Qwen3.8-27B 是 270 亿参数的稠密(Dense)多模态模型,显存需求取决于精度与上下文长度:
| 部署形态 | 权重体积(约) | 推荐硬件 | 适用场景 |
|---|---|---|---|
| BF16(原始精度) | 约 54 GB | 2 × A100/H100 80G(TP=2) | 生产高精度、长上下文 |
| FP8 量化 | 约 27 GB | 1 × A100/H100 80G 或 1 × RTX 5090 32G | 生产主流选择,性价比高 |
| AWQ 4-bit 量化 | 约 17 GB | 1 × RTX 4090/5090 24G | 开发测试、消费级显卡 |
注意:
Qwen3.8-27B 原生上下文为 262144 token,KV Cache 会随
--max-model-len线性增长。生产环境通常将上下文设为 32K–131K,显存有限时优先缩小--max-model-len,而不是降低--gpu-memory-utilization。
其余硬件建议:
| 项目 | 建议 |
|---|---|
| CPU | 建议 ≥ 16 核(TP=2 时 ≥ 32 核) |
| 内存 | 建议 ≥ 128 GB(权重加载、PyTorch 运行时开销) |
| 系统盘 | NVMe SSD ≥ 200 GB(模型权重 + 依赖) |
| 网络 | 生产环境 10GbE+,TP 多卡间需 NVLink / PCIe 高速互联 |
3.2 Rocky Linux 10 基础配置
# 更新系统

dnf update -y

# 部署基础工具链

dnf install -y epel-release

dnf install -y git curl wget htop tmux

dnf install -y python3 python3-pip python3-devel gcc gcc-c++ make

# 确认版本

cat /etc/rocky-release

uname -r

python3 --version
3.3 NVIDIA 驱动与 CUDA
使用 NVIDIA 官方仓库安装驱动与 CUDA Toolkit:
# 添加 NVIDIA CUDA 仓库

dnf config-manager --add-repo \

  https://developer.download.nvidia.com/compute/cuda/repos/rhel10/x86_64/cuda-rhel10.repo

dnf clean expire-cache

# 安装驱动(latest-dkms 便于内核升级后自动重建)

dnf module install -y nvidia-driver:latest-dkms

# 安装 CUDA 工具链(vLLM 的 wheel 自带 CUDA runtime,工具链主要用于编译扩展)

dnf install -y cuda-toolkit

# 验证驱动与 GPU 可见性

nvidia-smi
若
nvidia-smi提示版本过低,vLLM 官方 wheel 对驱动版本有最低要求(通常需要 ≥ 535/570 系列),请升级到最新稳定驱动。安装完成后建议重启一次,确保内核模块加载。
3.4 Python 虚拟环境
# 为 vLLM 单独建虚拟环境,避免污染系统 Python

mkdir -p /opt/vllm-venv /opt/models /opt/llm-gateway

python3 -m venv /opt/vllm-venv

# 后续命令统一先激活环境

source /opt/vllm-venv/bin/activate

pip install -U pip wheel setuptools
4. 获取模型权重
4.1 从 Hugging Face 下载
source /opt/vllm-venv/bin/activate

pip install -U huggingface_hub

hf download Qwen/Qwen3.8-27B --local-dir /data/vllm/models/Qwen3.8-27B
国内网络不佳时,可设置镜像:
export HF_ENDPOINT=https://hf-mirror.com后再执行下载。
4.2 从 ModelScope 下载(国内推荐)
source /opt/vllm-venv/bin/activate

pip install -U modelscope

modelscope download --model Qwen/Qwen3.8-27B --local_dir /data/vllm/models/Qwen3.8-27B
vLLM 也支持直接使用 ModelScope 仓库 ID 并配合环境变量:
export VLLM_USE_MODELSCOPE=true4.3 目录结构与校验
下载完成后确认关键文件齐全:
ls -lh /data/vllm/models/Qwen3.8-27B

# 预期包含:config.json、tokenizer.json、*.safetensors(或多个分片)、

#           generation_config.json、merges.txt、vocab.json 等

# 检查权重是否完整(safetensors 自带哈希校验)

python - <<'EOF'

from safetensors import safe_open

f = safe_open("/data/vllm/models/Qwen3.8-27B/model.safetensors", framework="pt")

print("tensor 数量:", len(f.keys()))

EOF
如需 FP8 / AWQ 量化版,可在 HF / ModelScope 搜索
Qwen3.8-27B-FP8、
Qwen3.8-27B-AWQ等官方或社区仓库,下载后路径同样放到
/opt/models/下。
5. 安装 vLLM
5.1 pip 安装
source /opt/vllm-venv/bin/activate

# 固定主版本,避免依赖漂移;当前最新为 0.29.x(V1 引擎)

pip install vllm==0.29.0
vLLM 从 0.29 起默认使用
V1 引擎
(V0 已弃用),Continuous Batching、Chunked Prefill、KV Cache 管理等能力内置默认开启。若后续升级,请先阅读对应版本
。
5.2 验证安装
source /opt/vllm-venv/bin/activate

vllm --version

python -c "import vllm; print(vllm.__version__)"
能正常输出版本号即安装成功。
6. 启动 vLLM OpenAI 兼容服务
6.1 最小启动命令
source /opt/vllm-venv/bin/activate

vllm serve /data/vllm/models/Qwen3.8-27B \

  --host 127.0.0.1 \

  --port 8000 \

  --served-model-name qwen3.8-27b \

  --max-model-len 131072 \

  --gpu-memory-utilization 0.90 \

  --max-num-seqs 256 \

  --trust-remote-code
启动成功后,控制台会输出监听地址 Uvicorn running on http://127.0.0.1:8000 以及 Application startup complete. 等日志。
6.2 关键参数详解
| 参数 | 说明 | 建议值 |
|---|---|---|
--host |
监听地址,只绑回环,由网关转发 | 127.0.0.1 |
--port |
服务端口 | 8000 |
--served-model-name |
客户端请求时使用的模型名 | qwen3.8-27b |
--api-key |
vLLM 自身接口密钥(纵深防御) | 强随机串 |
--tensor-parallel-size |
张量并行卡数(BF16 双卡场景设 2) | 按硬件 |
--max-model-len |
最大上下文长度 | 生产 32768–131072 |
--gpu-memory-utilization |
KV Cache 可用显存比例上限 | 0.85–0.95 |
--max-num-seqs |
单批并发序列数上限 | 128–512 |
--quantization |
量化方式:fp8 / awq / gptq |
按权重类型 |
--enable-reasoning |
开启思考模式输出(Qwen3.8 默认思考) | 按需 |
--reasoning-parser |
推理结果解析器 | qwen |
--enable-auto-tool-choice |
自动工具调用 | 按需 |
--tool-call-parser |
工具调用解析器 | hermes |
--enable-mtp |
多 token 预测加速(权重含 MTP 模块且版本支持时) | 按需 |
--trust-remote-code |
信任模型仓库中的自定义代码 | 官方权重必需 |
长上下文提示
:如需将
--max-model-len设为 262144 甚至更高,需额外设置环境变量
export VLLM_ALLOW_LONG_MAX_MODEL_LEN=1,并确保显存充足(长上下文的 KV Cache 占用极大,可能需多卡或缩小编号序列数)。
6.3 生产推荐启动脚本(FP8 单卡示例)
#!/usr/bin/env bash

# /opt/scripts/start_vllm.sh

set -e

export VLLM_ALLOW_LONG_MAX_MODEL_LEN=1   # 若需要 262K 超长上下文

export VLLM_LOGGING_LEVEL=info

source /opt/vllm-venv/bin/activate

exec vllm serve /data/vllm/models/Qwen3.8-27B-FP8 \

  --host 127.0.0.1 \

  --port 8000 \

  --served-model-name qwen3.8-27b \

  --api-key "${VLLM_API_KEY}" \

  --max-model-len 131072 \

  --gpu-memory-utilization 0.90 \

  --max-num-seqs 256 \

  --quantization fp8 \

  --enable-reasoning \

  --reasoning-parser qwen \

  --enable-auto-tool-choice \

  --tool-call-parser hermes \

  --trust-remote-code
6.4 服务自检
# 1) 健康检查(vLLM 原生端点)

curl -s http://127.0.0.1:8000/health            # 期望输出 {"status":"ok"} 或 ok

# 2) 查看已加载模型列表(需要 api-key 时带上)

curl -s http://127.0.0.1:8000/v1/models \

  -H "Authorization: Bearer ${VLLM_API_KEY}"

# 3) 直接调用验证(仅本机测试;生产必须走网关)

curl -s http://127.0.0.1:8000/v1/chat/completions \

  -H "Authorization: Bearer ${VLLM_API_KEY}" \

  -H "Content-Type: application/json" \

  -d '{

    "model": "qwen3.8-27b",

    "messages": [{"role": "user", "content": "你好,请用一句话自我介绍"}],

    "max_tokens": 128,

    "stream": false

  }'
7. SK 密钥鉴权与 FastAPI 网关
7.1 鉴权设计
鉴权模型:
- 平台为每个调用方(应用 / 团队 / 租户)颁发独立 SK(
sk-开头,≥ 32 位随机串); - 客户端请求时在
Authorization: Bearer <SK>中携带; - 网关对 SK 做 SHA-256 哈希后与白名单做常数时间比较(防时序攻击),并记录调用方与时间戳用于审计;
- 通过后可做按 SK 的限流(每分钟请求数上限),再转发至 vLLM。
密钥管理规范:
- 数据库中只存 SK 的哈希(加盐),不存明文;本文示例为了简洁用环境变量明文列表,生产建议接入密钥管理服务(Vault / KMS);
- SK 支持轮换:新旧 SK 同时有效一段时间,客户端灰度切换后再下线旧值;
- 网关日志中只记录 SK 前缀(如
sk-xxxx…),禁止记录完整密钥。
7.2 网关工程结构
/opt/llm-gateway/

├── requirements.txt

└── app/

  └── main.pyrequirements.txt:
fastapi>=0.115

uvicorn[standard]>=0.32

httpx>=0.27
7.3 网关核心代码
/opt/llm-gateway/app/main.py:
代码要点:
- 鉴权依赖(
Depends(_verify_sk))自动作用于所有业务路由,新增接口不会漏鉴权; hmac.compare_digest做常数时间比较;- 流式响应设置
X-Accel-Buffering: no,避免 Nginx 等反向代理缓冲导致 “首字延迟”; - 超时设置为 600 秒,兼容长上下文、长生成的请求。
7.4 环境变量配置
/etc/llm-gateway/gateway.env(示例,生产请用强随机密钥并妥善保管):
# 网关 -> vLLM

VLLM_BASE_URL=http://127.0.0.1:8000

VLLM_API_KEY=vllm-internal-key-change-me

# 合法 SK 列表(逗号分隔,可同时存在新旧密钥以便轮换)

SK_LIST=sk-richard-11223355,sk-richard-2244667788

# 限流:每个 SK 每分钟最多请求数

RATE_LIMIT=60
7.5 启动网关
mkdir -p /opt/llm-gateway

# 将 app/main.py 与 requirements.txt 放入 /opt/llm-gateway 后:

source /opt/vllm-venv/bin/activate

cd /opt/llm-gateway

pip install -r requirements.txt

# 前台启动(验证用)

set -a && source /etc/llm-gateway/gateway.env && set +a

uvicorn app.main:app --host 0.0.0.0 --port 8080
多 worker 时(
--workers N)内存限流按进程独立计数,属于近似限流;严格限流请改用 Redis 计数。
8. 集成测试
8.1 curl 测试
BASE=http://127.0.0.1:8080

# 1) 健康检查(无需鉴权)

curl -s $BASE/health

# 2) 正常调用(非流式)

curl -s $BASE/v1/chat/completions \

  -H "Authorization: Bearer sk-test-123456" \

  -H "Content-Type: application/json" \

  -d '{

    "model": "qwen3.8-27b",

    "messages": [{"role": "user", "content": "用一句话介绍 Rocky Linux"}],

    "max_tokens": 128,

    "stream": false

  }'

# 3) 流式调用

curl -N -s $BASE/v1/chat/completions \

  -H "Authorization: Bearer sk-test-123456" \

  -H "Content-Type: application/json" \

  -d '{

    "model": "qwen3.8-27b",

    "messages": [{"role": "user", "content": "写一首关于大模型的小诗"}],

    "max_tokens": 256,

    "stream": true

  }'

# 4) 错误密钥 → 期望 401

curl -s -o /dev/null -w "HTTP %{http_code}n" \

  $BASE/v1/chat/completions \

  -H "Authorization: Bearer sk-wrong-key" \

  -H "Content-Type: application/json" \

  -d '{"model":"qwen3.8-27b","messages":[{"role":"user","content":"hi"}]}'

# 输出: HTTP 401

# 5) 缺失密钥 → 期望 401

curl -s -o /dev/null -w "HTTP %{http_code}n" \

  $BASE/v1/chat/completions \

  -H "Content-Type: application/json" \

  -d '{"model":"qwen3.8-27b","messages":[{"role":"user","content":"hi"}]}'

# 输出: HTTP 401
8.2 OpenAI SDK 测试(Python)
source /opt/vllm-venv/bin/activate

pip install openai
from openai import OpenAI
client = OpenAI(
  api_key="sk-test-123456", # 网关下发的 SK
  base_url="http://127.0.0.1:8080/v1", # 指向网关
)
resp = client.chat.completions.create(
  model="qwen3.8-27b",
  messages=[{"role": "user", "content": "解释一下什么是 KV Cache"}],
  stream=True,
)
for chunk in resp:
  if chunk.choices and chunk.choices[0].delta.content:
  print(chunk.choices[0].delta.content, end="", flush=True)Qwen3.8-27B 默认开启思考模式,流式输出中可能先出现
reasoning_content(思考过程)再出现
content(最终回答),SDK 按需展示即可。
8.3 压测建议
# vLLM 自带压测工具(走直连,用于基准性能基线)

vllm bench serve \

  --model /data/vllm/models/Qwen3.8-27B \

  --dataset-name random \

  --random-input 512 --random-output 256 \

  --num-prompts 200 --request-rate 10 \

  --save-result --result-dir /opt/bench

# 网关层压测:用 wrk / hey 打网关,重点观察鉴权链路与流式吞吐
9. 生产化部署
9.1 systemd 托管
vLLM 服务(/etc/systemd/system/vllm.service):
[Unit]

Description=vLLM OpenAI Compatible Server (Qwen3.8-27B)

After=network-online.target

Wants=network-online.target

[Service]

Type=simple

User=vllm

Group=vllm

EnvironmentFile=/etc/vllm/vllm.env

ExecStart=/opt/vllm-venv/bin/vllm serve /data/vllm/models/Qwen3.8-27B-FP8 \

    --host 127.0.0.1 --port 8000 \

    --served-model-name qwen3.8-27b \

    --max-model-len 131072 \

    --gpu-memory-utilization 0.90 \

    --max-num-seqs 256 \

    --quantization fp8 \

    --enable-reasoning --reasoning-parser qwen \

    --trust-remote-code

Restart=on-failure

RestartSec=10

LimitNOFILE=65535

[Install]

WantedBy=multi-user.target
FastAPI 网关服务(/etc/systemd/system/llm-gateway.service):
[Unit]

Description=LLM Gateway (FastAPI + SK Auth)

After=network-online.target vllm.service

Wants=network-online.target

[Service]

Type=simple

User=vllm

Group=vllm

EnvironmentFile=/etc/llm-gateway/gateway.env

WorkingDirectory=/opt/llm-gateway

ExecStart=/opt/vllm-venv/bin/uvicorn app.main:app \

    --host 0.0.0.0 --port 8080

Restart=on-failure

RestartSec=5

LimitNOFILE=65535

[Install]

WantedBy=multi-user.target创建服务用户并启用:
useradd -r -s /usr/sbin/nologin vllm

usermod -aG video,render vllm          # 赋予 GPU 访问权限

systemctl daemon-reload

systemctl enable --now vllm llm-gateway

systemctl status vllm llm-gateway
9.2 防火墙与 SELinux
# 只对公网开放网关端口 8080

firewall-cmd --permanent --add-port=8080/tcp

firewall-cmd --reload

# vLLM 仅绑定 127.0.0.1,无需开放 8000 外网端口

# 查看 SELinux 状态

getenforce

# 若为 Enforcing 且服务启动异常(如无法监听端口),

# 用 audit2allow 生成策略,而不是直接 setenforce 0:

ausearch -m avc --start recent | audit2allow -M llm_gateway

semodule -i llm_gateway.pp
9.3 日志与监控
日志:
# 查看服务日志

journalctl -u vllm -f

journalctl -u llm-gateway -f

# 网关审计(建议接入 ELK / Loki):记录调用方 SK 前缀、模型、耗时、token 数监控:
- vLLM 内置 Prometheus 指标端点
http://127.0.0.1:8000/metrics,包含吞吐(tokens/s)、请求延迟分位数、KV Cache 使用率、GPU 利用率等; - 在 Prometheus 中配置抓取任务后,用 Grafana 展示关键面板(
vllm:num_requests_running、vllm:gpu_cache_usage_perc等); - 网关侧可用
prometheus_client暴露gateway_requests_total、gateway_sk_active等业务指标。
9.4 安全加固清单
| 措施 | 说明 |
|---|---|
| 密钥轮换 | SK 定期轮换,新旧并存灰度切换 |
| 传输加密 | 网关对外暴露时,前端加 Nginx/Caddy 终止 TLS(HTTPS) |
| 请求签名(进阶) | 在 SK 基础上叠加 HMAC-SHA256 签名(时间戳 + 请求体哈希),防重放与篡改 |
| 超时与限流 | 网关设置读超时与每 SK 限流;必要时按模型、按 IP 分级限流 |
| 最小权限 | vLLM / 网关用独立低权限用户运行;模型目录只读 |
| 审计日志 | 记录调用方、时间、模型、输入 / 输出长度,脱敏后留存 |
10. 性能调优
| 场景 | 调优手段 |
|---|---|
| 显存不足 / OOM | 降低 --max-model-len 与 --max-num-seqs;改 FP8 / AWQ 量化;加大 --tensor-parallel-size |
| 吞吐优先 | 提高 --max-num-seqs 至 256–512;开启 --enable-mtp(若权重含 MTP 模块且版本支持);保证 --gpu-memory-utilization ≥ 0.90 |
| 首 token 延迟优先 | 调小 --max-num-seqs(减少排队);开启 --enable-chunked-prefill(V1 默认开启);长提示词场景配合前缀缓存 |
| 长上下文业务 | 设置 --max-model-len 与业务对齐(32K/128K),不要无脑拉满 262K 造成 KV Cache 浪费 |
| 多卡扩展 | BF16 双卡用 --tensor-parallel-size 2;横向扩容部署多个 vLLM 副本,前置负载均衡 |
| 思考模式控制 | 客户端可通过 reasoning_effort、max_thinking_tokens 等参数调节推理深度(参考 vLLM Reasoning 文档) |
基准建议:上线前用 vllm bench serve 在目标硬件上建立吞吐 / 延迟基线(见 8.3),后续调参以基线数据为准,避免拍脑袋。
11. 常见问题 FAQ
Q1:启动报 CUDA out of memory?
降低 --max-model-len、--max-num-seqs、--gpu-memory-utilization 之一;或改用 FP8/AWQ 量化、增加 TP 卡数。
Q2:模型下载很慢或失败?
设置 export HF_ENDPOINT=https://hf-mirror.com;或改用 ModelScope:export VLLM_USE_MODELSCOPE=true,或 modelscope download 到本地目录。
Q3:客户端报 model not found?
检查请求中的 model 字段与 --served-model-name 是否一致(本文为 qwen3.8-27b)。
Q4:流式输出被缓冲、首字很慢?
确认网关转发了 X-Accel-Buffering: no;若前端还有 Nginx,设置 proxy_buffering off;。
Q5:如何关闭 / 调节思考模式?
Qwen3.8-27B 默认思考。可在请求中传 reasoning_effort 或 max_thinking_tokens: 0 控制;启动参数 --enable-reasoning 控制是否解析 reasoning 输出。
Q6:--max-model-len 262144 报错被拒?
需要 export VLLM_ALLOW_LONG_MAX_MODEL_LEN=1,并确认显存能容纳超长上下文的 KV Cache。
Q7:vLLM 升级后部分旧参数不识别?
0.29 默认 V1 引擎,--enable-chunked-prefill 等旧参数已内置或移除;以当前版本文档为准,必要时用 vllm serve --help 核对。
Q8:SK 泄露了怎么办?
立即在网关的 SK_LIST 中下线该密钥并重启网关;若接入了密钥管理系统,直接吊销对应 SK,同时检查审计日志中该 SK 的历史调用。
Q9:多副本部署后网关限流不准?
内存限流按进程独立计数;多 worker / 多副本场景改用 Redis 集中计数。
Q10:如何验证鉴权是否真正生效?
用无密钥、错误密钥、正确密钥分别请求网关,确认返回 401 / 401 / 200;再直连 127.0.0.1:8000,确认未设置 vLLM --api-key 时直连被防火墙 / 绑定限制住。
12. 参考资料
- vLLM 官方文档:https://docs.vllm.ai/en/latest/
- vLLM V1 引擎说明:https://docs.vllm.ai/en/latest/usage/v1_guide/
- vLLM 发布页(PyPI):https://pypi.org/project/vllm/
- Qwen 部署文档(vLLM):https://qwen.readthedocs.io/en/latest/deployment/vllm.html
- Qwen3.8-27B(Hugging Face):https://huggingface.co/Qwen/Qwen3.8-27B
- Qwen3.8-27B(ModelScope):https://modelscope.cn/models/Qwen/Qwen3.8-27B
- Rocky Linux 版本发布页:https://docs.rockylinux.org/releases/
- FastAPI 官方文档:https://fastapi.tiangolo.com/
- NVIDIA CUDA 仓库(RHEL10):https://developer.download.nvidia.com/compute/cuda/repos/rhel10/x86_64/
声明
本文命令与参数基于 vLLM 0.29、Rocky Linux 10.2、Qwen3.8-27B 是截止2026.8.22官方权重编写;模型 ID、仓库地址、软件版本以官方最新发布为准。
